GPU : c’est quoi, et pourquoi l’intelligence artificielle ne peut pas s’en passer ?
Définition : GPU 💡
Un GPU (Graphics Processing Unit, processeur graphique) est une puce conçue pour faire des milliers de calculs simples en même temps, là où le processeur central (CPU) enchaîne des tâches complexes une par une. Or une intelligence artificielle se résume à des milliards de multiplications identiques, faites en parallèle. C’est pour ça que l’IA tourne sur des GPU, avec leur mémoire ultrarapide, leurs cœurs Tensor et l’écosystème CUDA de Nvidia. Pour utiliser ChatGPT, aucun GPU n’est requis. Pour faire tourner une IA chez vous, c’est la VRAM qui compte.
21 760. C’est le nombre de cœurs de calcul logés dans une GeForce RTX 5090, la carte graphique grand public la plus puissante de Nvidia. Le processeur de votre PC en compte probablement entre 8 et 24. Et pourtant, ce n’est pas votre CPU qui est dépassé : les deux puces ne jouent simplement pas le même jeu.
Cette différence explique pourquoi Meta, Google, OpenAI et Microsoft s’arrachent des GPU par centaines de milliers, pourquoi Nvidia est devenue l’une des entreprises les plus riches de la planète, et pourquoi le prix de votre future carte graphique grimpe. Voici ce qu’est un GPU, pourquoi l’IA ne sait pas s’en passer, et ce que ça change pour vous.
Qu’est-ce qu’un GPU ?
Un GPU, pour Graphics Processing Unit (processeur graphique en français), est une puce spécialisée dans le calcul d’images. Le terme a été popularisé par Nvidia en 1999, avec la sortie de la GeForce 256, vendue comme « le premier GPU au monde ». Un coup de marketing, mais le nom est resté.
Son métier d’origine : calculer la couleur de chaque pixel affiché à l’écran. Une image en 4K, c’est 8,3 millions de pixels. Dans un jeu à 60 images par seconde, il faut donc recalculer près de 500 millions de pixels chaque seconde, avec les ombres, les reflets et la lumière. Aucun processeur classique ne tient ce rythme.
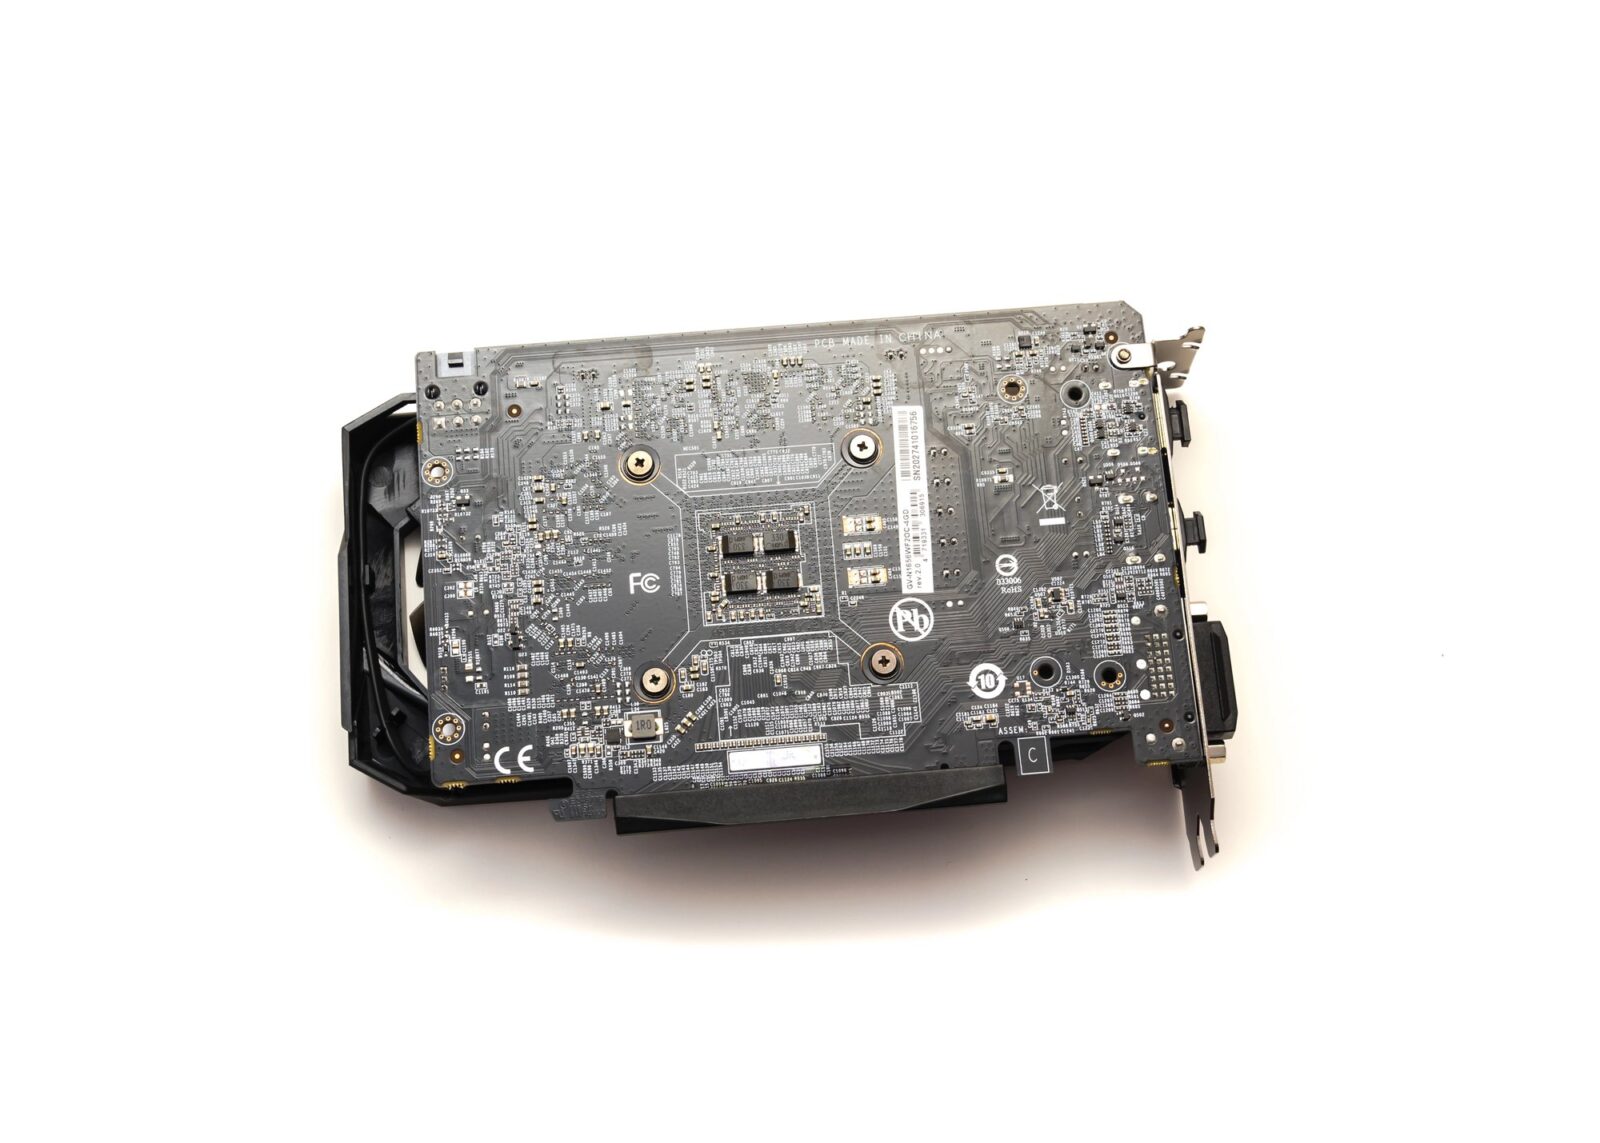
Au passage, ne confondez pas GPU et carte graphique. Le GPU, c’est la puce. La carte graphique, c’est la carte complète : le GPU, sa mémoire dédiée (la VRAM), son alimentation et ses ventilateurs. Et tous les GPU ne sont pas sur une carte :
- Le GPU intégré est logé dans le processeur lui-même. Il partage la mémoire vive du PC. C’est le cas de la plupart des PC portables de bureautique et des Mac.
- Le GPU dédié est une puce indépendante avec sa propre mémoire, sur une carte graphique (PC fixe) ou soudée sur la carte mère (PC portable gamer).
Si vous ne savez pas lequel équipe votre machine, j’explique comment identifier le modèle de votre carte graphique en deux minutes.
CPU contre GPU : le chef étoilé et la cantine
Pour comprendre la différence, j’aime bien une image de cuisine.
Le CPU (le processeur central de l’ordinateur), c’est une brigade de quelques chefs étoilés. Chacun sait tout faire : une sauce compliquée, un dessert, une improvisation quand un client change sa commande. Ils sont rapides, polyvalents et très malins. Mais ils ne sont qu’une poignée.
Le GPU, c’est une cantine avec des milliers de commis. Chaque commis ne sait faire qu’une chose simple : éplucher, couper, verser. Mais quand il faut sortir 10 000 assiettes identiques en même temps, la cantine écrase la brigade étoilée.
Concrètement, le CPU est taillé pour les tâches séquentielles et variées : lancer Windows, ouvrir un navigateur, gérer vos fichiers, prendre des décisions en cascade. Le GPU est taillé pour le calcul parallèle : appliquer la même opération à des millions de données d’un coup. Ce n’est pas l’un ou l’autre. Votre PC a besoin des deux, chacun dans son rôle.
Pourquoi l’IA a besoin des GPU
Maintenant que le décor est planté, voyons ce qui se passe dans une IA.
Une IA moderne, qu’il s’agisse de ChatGPT, d’un générateur d’images ou de la reconnaissance vocale de votre téléphone, repose sur un réseau de neurones artificiels. Derrière ce nom poétique se cache une réalité très terre à terre : des tableaux de nombres (les fameux paramètres) qu’on multiplie entre eux, encore et encore. Un grand modèle de langage (LLM) compte des dizaines, voire des centaines de milliards de paramètres. Pour produire un seul mot de réponse, il faut toutes les mobiliser.
Soyons clairs : il n’y a rien de compliqué dans chaque calcul. Une multiplication, une addition. Le problème, c’est le volume. Et c’est exactement le travail de la cantine, pas des chefs étoilés. Trois raisons font du GPU la puce idéale pour ça.
Premier atout : le parallélisme massif
Les milliards de multiplications d’un réseau de neurones sont indépendantes les unes des autres. On peut donc les lancer toutes en même temps. Un CPU à 16 cœurs en traite 16 lots à la fois. Un GPU à plusieurs milliers de cœurs en traite des milliers. Sur ce type de charge, l’écart se compte en dizaines, voire centaines de fois plus vite.
Deuxième atout : une mémoire qui crache les données
Calculer vite ne sert à rien si les données arrivent au compte-gouttes. Or une IA doit lire tous ses paramètres à chaque étape. Le débit de la mémoire devient le vrai goulot d’étranglement.
Ça donne quoi en chiffres ? La mémoire vive (RAM) DDR5 d’un PC récent tourne autour de 90 à 100 Go/s en double canal. La VRAM GDDR7 d’une RTX 5090 monte à 1,79 To/s, soit près de vingt fois plus. Et les GPU de data center, équipés de mémoire HBM empilée directement à côté de la puce, vont encore bien au-delà.
Troisième atout : des cœurs taillés pour l’IA
Depuis 2017, Nvidia intègre dans ses GPU des cœurs Tensor, des circuits spécialisés dans les multiplications de matrices (ces fameux tableaux de nombres). Ils travaillent en précision réduite : au lieu de coder chaque nombre sur 32 bits, ils se contentent de 16, 8, voire 4 bits. Pour une IA, cette approximation ne change presque rien au résultat. Pour la vitesse, ça change tout.
Et le vrai secret de Nvidia : CUDA
Reste une question : pourquoi Nvidia et pas AMD ou Intel, qui fabriquent aussi des GPU ? La réponse tient en quatre lettres : CUDA.
Lancée en 2007, CUDA est la plateforme logicielle qui permet aux développeurs de programmer les GPU Nvidia pour autre chose que du jeu vidéo. Près de vingt ans plus tard, tous les grands outils de l’IA (PyTorch, TensorFlow, les bibliothèques de calcul scientifique) sont optimisés d’abord pour CUDA. Les chercheurs ont appris dessus, les logiciels sont écrits pour, les tutoriels en parlent. C’est ce verrou logiciel, bien plus que la puce elle-même, qui fait la domination de Nvidia.
2012 : deux cartes de jeu dans une chambre
L’histoire mérite d’être racontée, parce qu’elle a tout déclenché.
En 2012, un étudiant de l’université de Toronto, Alex Krizhevsky, entraîne un réseau de neurones baptisé AlexNet pour reconnaître le contenu de photos. Son matériel ? Deux cartes graphiques GeForce GTX 580 de 3 Go, des cartes de joueur, installées dans un PC chez ses parents. Le réseau est même trop gros pour une seule carte : il le coupe en deux, une moitié par GPU.
Résultat : AlexNet remporte le concours ImageNet avec un taux d’erreur de 15,3 %, contre 26,2 % pour le deuxième. Un écart énorme, dans une compétition où les équipes se battaient pour quelques dixièmes de point. Le message est passé dans toute la communauté : avec des GPU, l’apprentissage profond (deep learning) devient enfin praticable. L’intelligence artificielle moderne est née ce jour-là, sur du matériel de gamer.
Entraînement et inférence : deux appétits très différents
Une IA consomme des GPU à deux moments, et il faut bien les distinguer.
L’entraînement, c’est la fabrication du modèle. On lui fait avaler des montagnes de textes ou d’images pendant des semaines, pour ajuster ses milliards de paramètres. C’est là que les chiffres donnent le vertige. Pour entraîner Llama 3.1 405B, son plus gros modèle ouvert, Meta a mobilisé plus de 16 000 GPU H100 en parallèle, pendant près de deux mois. Chacune de ces puces de data center se négocie plusieurs dizaines de milliers d’euros. Faites le calcul.
L’inférence, c’est l’utilisation du modèle une fois prêt. Chaque question posée à ChatGPT, chaque image générée, chaque résumé automatique fait travailler des GPU dans un data center, quelque part dans le cloud. Une requête isolée coûte peu. Des centaines de millions par jour, beaucoup.
Cette double demande a créé une ruée. Selon les estimations du cabinet IDC, Nvidia détient autour de 80 % du marché des puces d’IA pour data center. Sa nouvelle génération, Vera Rubin, est livrée depuis le second semestre 2026, et les commandes sont réservées longtemps à l’avance. L’effet de bord, vous le payez : les usines et la mémoire partent en priorité vers l’IA, ce qui explique en partie pourquoi les prix des cartes graphiques grimpent pour les joueurs.
GPU, NPU, TPU : qui fait quoi ?
Le GPU n’est plus seul sur le terrain de l’IA. Deux autres sigles circulent, et ils sèment la confusion.
- Le NPU (Neural Processing Unit, processeur neuronal) est une petite unité intégrée aux processeurs récents, spécialisée dans l’IA légère et économe en énergie. Microsoft exige un NPU d’au moins 40 TOPS (40 000 milliards d’opérations par seconde) pour le label Copilot+ PC. Il sert au floutage d’arrière-plan en visio, à la transcription ou aux fonctions IA de Windows, sans vider la batterie. Pour faire tourner un gros modèle, il reste loin derrière un GPU dédié.
- Le TPU (Tensor Processing Unit) est la puce maison de Google, conçue uniquement pour l’IA. Vous ne l’achèterez jamais : elle tourne dans les data centers de Google et fait fonctionner Gemini.
Et les Mac ? Les puces Apple Silicon combinent CPU, GPU et NPU sur une même puce, avec une mémoire unifiée partagée par tous. Un Mac doté de beaucoup de mémoire peut donc charger des modèles d’IA plus gros qu’une carte graphique grand public, au prix d’une vitesse moindre. Les mini PC suivent la même voie, comme ceux que GEEKOM présentait à l’IFA 2026, pensés pour faire tourner l’IA en local.
Faut-il un GPU pour utiliser l’IA chez vous ?
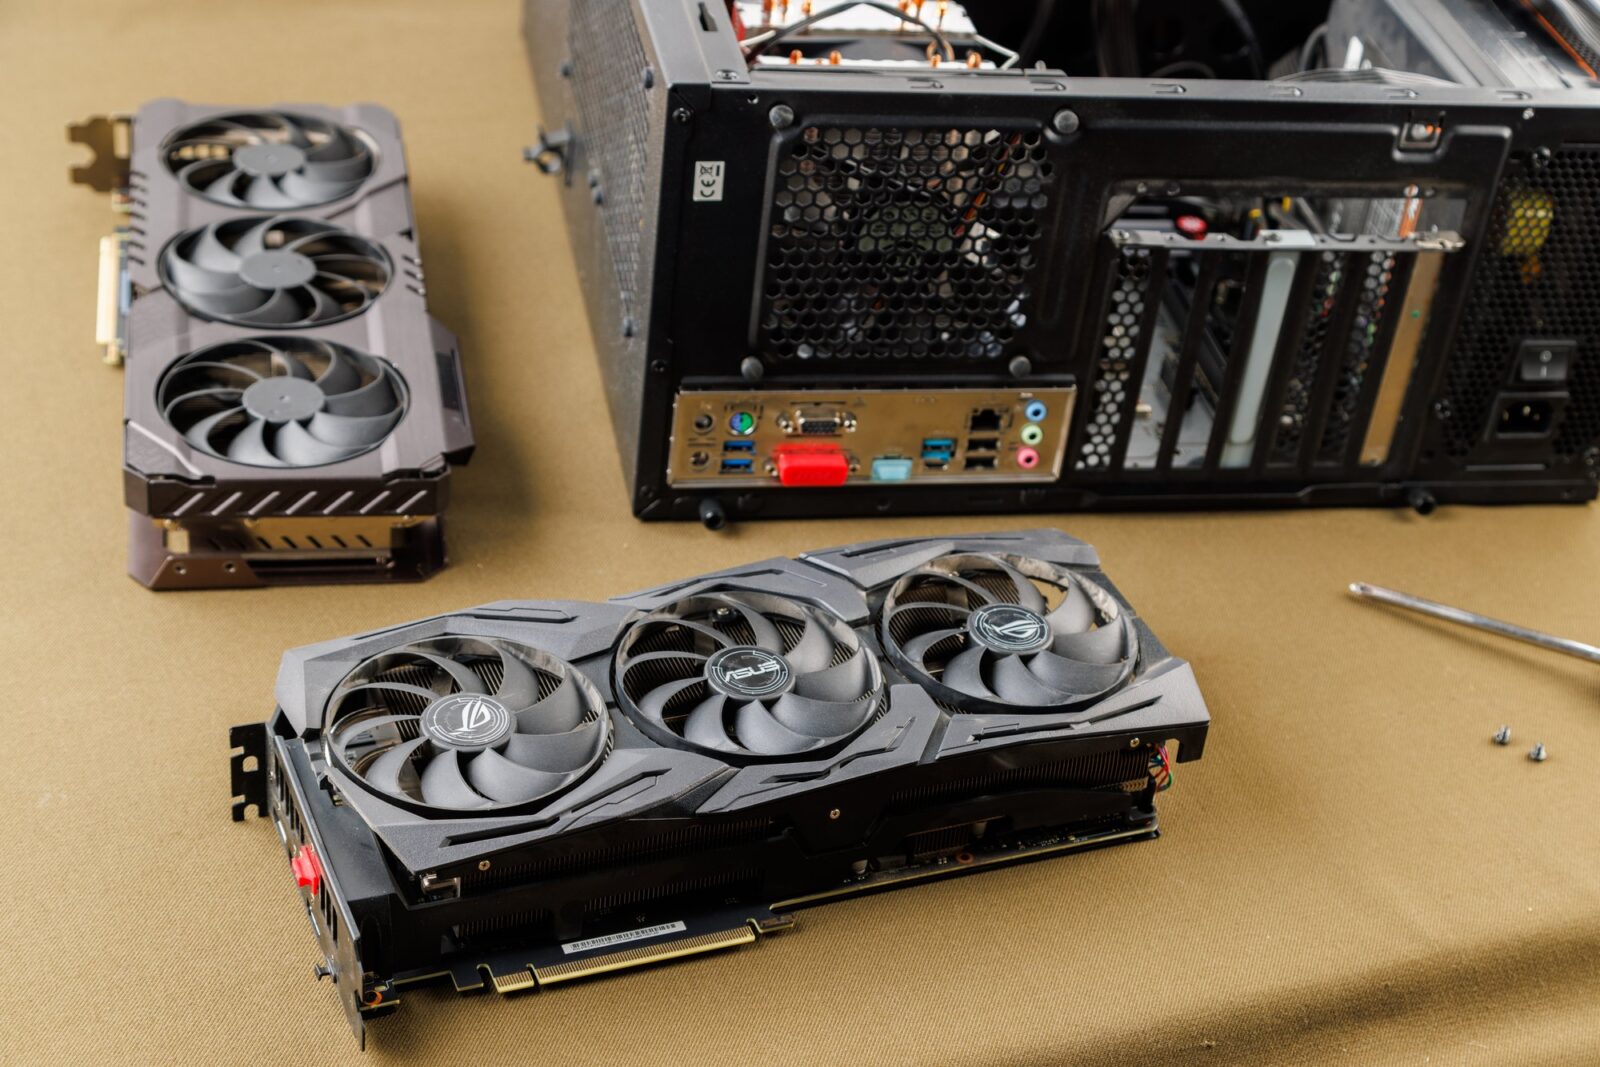
Voilà pour la théorie. En pratique, ça donne quoi pour vous ?
Pour ChatGPT, Gemini, Copilot ou Claude, la réponse est non. Tout le calcul se fait dans les data centers de l’éditeur. Votre PC n’affiche que la réponse. Un vieux portable de bureautique fait parfaitement l’affaire. Pas la peine d’acheter une carte graphique pour ça.
Pour faire tourner une IA en local, sur votre propre machine, c’est une autre histoire. Avec des logiciels comme Ollama ou LM Studio (pour les modèles de texte) ou ComfyUI (pour la génération d’images), le GPU devient indispensable. L’intérêt : vos données ne quittent pas votre PC, et aucun abonnement n’est requis.
Et là, le critère numéro un n’est pas la puissance de calcul. C’est la quantité de VRAM. Le modèle doit tenir entièrement dans la mémoire de la carte, sinon il déborde sur la RAM du PC et tout ralentit d’un coup. Quelques ordres de grandeur, pour des modèles compressés en 4 bits (la méthode courante pour l’usage local) :
- 8 Go de VRAM : modèles d’environ 7 à 8 milliards de paramètres. Correct pour discuter, résumer, reformuler.
- 12 à 16 Go : modèles de 12 à 14 milliards de paramètres, et génération d’images confortable.
- 24 à 32 Go : modèles de 30 milliards de paramètres environ, le haut de gamme grand public.
- Autour de 48 Go : modèles de 70 milliards de paramètres. On sort du grand public : deux cartes, une carte pro, ou un Mac bien doté en mémoire unifiée.
Pensez aussi à garder vos pilotes graphiques à jour : les optimisations pour l’IA arrivent souvent par là.
Mes recommandations
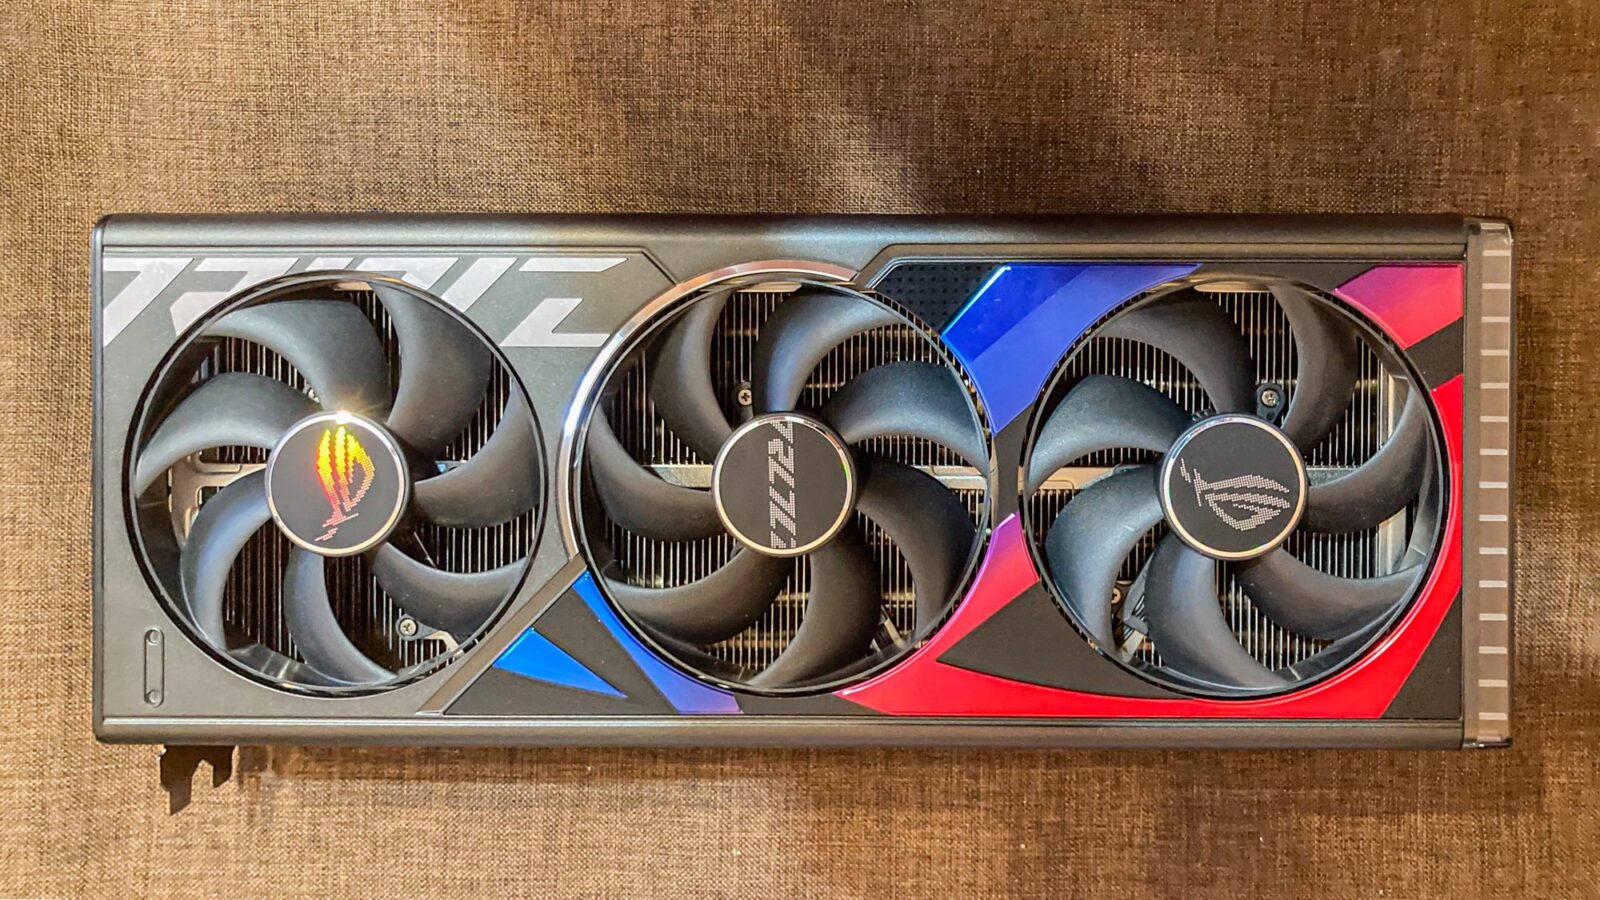
Si je devais vous conseiller pour un PC orienté IA locale, voilà ce que je ferais.
Premier réflexe : privilégiez la VRAM à la puissance brute. Une carte milieu de gamme avec 16 Go de mémoire vous rendra plus de services qu’une carte plus rapide limitée à 8 Go. En dessous de 12 Go, vous serez vite frustré.
Deuxième chose : restez chez Nvidia si vous débutez. AMD progresse avec sa plateforme ROCm, et ses cartes offrent souvent plus de mémoire pour le prix. Mais en vrai, la quasi-totalité des tutoriels et des logiciels partent du principe que vous avez une carte Nvidia. Vous gagnerez des heures de bidouille.
Et le plus important : n’achetez pas de GPU pour l’IA si vous n’en avez pas l’usage. Si vous vous contentez des assistants en ligne, gardez votre argent. Un GPU puissant chauffe, consomme et coûte cher. Il ne se justifie que si vous jouez, montez de la vidéo ou voulez vraiment garder votre IA chez vous.
Ce qu’il faut retenir
Le GPU n’a rien de magique. C’est une puce qui fait des choses simples, mais des milliers à la fois, avec une mémoire capable de suivre. L’IA a eu besoin exactement de ça, et Nvidia avait le logiciel prêt au bon moment.
Pour passer à l’action :
- Vérifiez quel GPU équipe votre PC et combien de VRAM il embarque, avant de vous lancer dans l’IA locale.
- Testez un petit modèle avec Ollama ou LM Studio : un modèle de 7 à 8 milliards de paramètres tourne sur une carte de 8 Go.
- Si vous achetez, regardez la VRAM avant tout le reste.
Mon avis tranché : pour 90 % des gens, le meilleur GPU pour l’IA, c’est celui du data center d’un autre. Le jour où vous voulez de la confidentialité ou de l’autonomie, une carte Nvidia de 16 Go est le bon point de départ.
Foire aux questions
GPU signifie Graphics Processing Unit, soit processeur graphique en français. C’est la puce qui calcule les images affichées à l’écran. Grâce à son architecture parallèle, elle sert aussi aujourd’hui au calcul scientifique et à l’intelligence artificielle.
Le GPU est la puce de calcul. La carte graphique est le composant complet qui l’accueille, avec sa mémoire dédiée (VRAM), son alimentation et son système de refroidissement. Un GPU intégré au processeur fonctionne, lui, sans carte graphique.
Oui, en utilisant des services en ligne comme ChatGPT ou Gemini, qui calculent tout sur leurs serveurs. En local, un CPU peut faire tourner de petits modèles, mais très lentement. Pour un usage confortable, un GPU dédié ou une puce Apple Silicon reste nécessaire.
Oui. AMD propose la plateforme ROCm, et des logiciels comme Ollama ou LM Studio prennent en charge ses cartes récentes. La compatibilité reste moins large que chez Nvidia, dont l’écosystème CUDA est la référence des développeurs. Vérifiez la prise en charge de votre carte avant de vous lancer.
La demande des géants du numérique dépasse largement la production, et Nvidia domine le marché. Les puces de data center embarquent aussi une mémoire HBM coûteuse à fabriquer. Cette pression se répercute en partie sur les cartes graphiques grand public.
Pas pour les gros modèles. Le NPU est conçu pour des tâches d’IA légères et économes en énergie, comme le floutage en visio ou la transcription. Pour faire tourner un modèle de langage ou générer des images en local, le GPU reste nettement plus rapide.
Sous Windows 10 et 11, ouvrez le Gestionnaire des tâches (Ctrl + Maj + Échap), onglet Performances, puis cliquez sur GPU. Le modèle s’affiche en haut à droite, et la ligne Mémoire GPU dédiée vous donne la quantité de VRAM. Sur Mac, passez par le menu Pomme, puis À propos de ce Mac : pas la peine d’installer un logiciel pour ça.



Commentaires
Laisser un commentaire